Prediga los incumplimientos de SLA antes de que ocurran con la IA de monday service
September 24, 2026
Un ticket queda esperando en la cola durante seis horas antes de que alguien note que pertenece a un cliente que renueva un contrato importante la próxima semana. Cuando un agente finalmente lo abre, el cronómetro del SLA ya está en rojo. Esto no es un problema de capacitación ni de personal. Es un problema de visibilidad, y se repite semana tras semana en equipos de servicio que todavía atienden los tickets en el orden en que llegan y no en el orden en que realmente importan.
La mayoría de las organizaciones de servicio no carecen de datos. El volumen de tickets, la carga de trabajo de cada agente, el tono de las solicitudes y el historial de resolución ya existen en algún lugar del sistema. Lo que falta es la capacidad de actuar sobre esos datos antes de que venza un plazo, no después de confirmar que se venció.
Esta guía se enfoca específicamente en la IA de monday service, el producto de gestión de servicio de monday.com, y responde las dos preguntas que realmente importan a cualquier líder de servicio:
Las expectativas de los clientes sobre la velocidad de respuesta avanzaron más rápido que los procesos de la mayoría de los equipos de servicio. Según la investigación CX Trends 2026 de Zendesk, el 81% de los consumidores espera hoy un servicio más rápido que hace apenas un año, y el tiempo medio de primera respuesta entre mesas de ayuda ronda las tres horas y catorce minutos, incluso con la desviación de tickets que ya aporta la IA.
La asignación por turnos o manual empeora el problema: un ticket de una cuenta empresarial en riesgo de cancelación y una solicitud rutinaria de restablecimiento de contraseña entran a la misma cola y, salvo que alguien note la diferencia, se atienden en el orden de llegada. No existe un mecanismo inherente que reconozca el impacto en el negocio, solo la cronología.
El costo de equivocarse en esto no es abstracto:
Para cuando un panel se pone en rojo, el SLA generalmente ya se incumplió. Los reportes tradicionales le dicen a un líder de servicio lo que ya pasó; casi nunca le dicen lo que está por pasar mientras todavía hay tiempo de intervenir.
Nada de esto es una crítica a los agentes que hacen el trabajo. Un agente capacitado que atiende cuarenta tickets abiertos simplemente no puede reordenar toda esa cola cada pocos minutos a medida que llega nueva información. Ese tipo de reordenamiento continuo entre decenas de variables cambiantes es exactamente el tipo de problema para el que un software está mejor preparado que una persona revisando la cola entre una llamada y otra.
Hay una diferencia real entre una plataforma donde la IA es nativa desde el primer tablero y una plataforma donde la IA es un widget de chat añadido sobre un flujo de trabajo que en el fondo no cambió. monday service pertenece al primer grupo.
Como corre sobre el Work OS más amplio de monday.com, GB Advisors suele describirle a sus clientes a monday.com como una plataforma de trabajo con IA integrada, más que como un conjunto de herramientas aisladas. Ese enfoque importa específicamente para un equipo de servicio: la IA no es un módulo que se configura una vez y se olvida. Aparece como:
Para una mirada más amplia de cómo funciona esta capa de IA en todo monday.com, nuestra guía sobre Cómo los agentes de IA de monday.com ejecutan trabajo real cubre las capacidades de la plataforma en las que se apoya esta sección.
monday service viene con un número reducido de agentes de IA diseñados para tareas puntuales, en lugar de un solo asistente general que intenta hacer de todo. Cada uno tiene un trabajo específico y acotado, y esa especialización es parte de por qué los equipos realmente pueden confiar en ellos.
En el momento en que llega una solicitud, este agente:
En la práctica, un correo escrito en tono frustrado y negativo puede marcarse y escalarse automáticamente a prioridad alta antes de que un agente siquiera lo vea, simplemente porque la señal de sentimiento contradice una clasificación rutinaria.
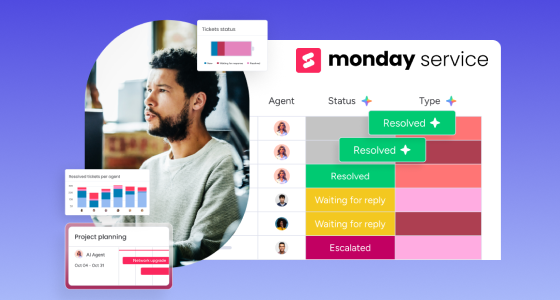
Cada ticket en monday service tiene una columna nativa de SLA con un cronómetro en vivo y uno de cuatro estados:
Los tiempos objetivo se configuran por prioridad, tipo de solicitud o sentimiento detectado. El agente monitor de SLA revisa continuamente cada ticket activo contra esos tiempos y alerta de forma proactiva a los responsables cuando un caso está en riesgo, en lugar de esperar a que alguien abra un panel y lo note por su cuenta.
Este agente busca picos o caídas inusuales en el desempeño del SLA en todo el tablero, un patrón que suele señalar algo más grande que un ticket difícil aislado, como:
Detectar ese patrón desde el primer día, en lugar de después de veinte incumplimientos ya registrados, es la diferencia entre un incidente aislado y un trimestre complicado.
Ayuda ver esto como una secuencia y no como una lista de funciones. Un cliente escribe a soporte un viernes a las 4:50 p. m., frustrado porque una integración de pagos dejó de funcionar en medio del checkout.
Nada de esto requirió una regla de escalamiento a medida para incidentes de pagos un viernes por la tarde. Fue el resultado directo de la detección de sentimiento, la calificación por impacto en el negocio y una alerta predictiva trabajando juntas sobre datos que la plataforma ya tenía.
La priorización dinámica permite que la urgencia cambie según el contexto. Un ticket avanza por delante de solicitudes rutinarias, incluso si llegó después, cuando involucra:
La asignación inteligente aplica la misma lógica a la distribución del trabajo: en lugar de una rotación estricta por turnos, la asignación basada en IA considera la prioridad, el sentimiento detectado y las habilidades de cada agente antes de entregar un ticket.
Según la investigación State of Service de Salesforce, los equipos que combinan triage con IA y enrutamiento basado en prioridad reportan un 37% menos de incumplimientos de SLA frente a los equipos que aún dependen de una rotación simple por turnos, una diferencia considerable para un cambio que no requiere contratar a nadie más.
Esta misma lógica ya existe en otras partes del ecosistema de monday.com. Nuestra guía sobre Pronóstico de Ventas y Priorización de Leads con IA en monday CRM explica cómo monday CRM ordena las oportunidades de venta según su probabilidad de cierre y no según cuándo entraron al embudo. Si una oportunidad de venta puede calificarse por su probabilidad de convertir, un ticket puede calificarse de la misma manera por su probabilidad de incumplir el SLA.
La predicción es la capacidad que separa a la gestión de servicio con IA real de la gestión de servicio con IA solo de nombre. Los modelos predictivos analizan:
...para pronosticar qué SLA probablemente se incumplirán horas antes de que llegue el plazo real, dándole a un responsable el margen suficiente para reasignar trabajo, escalar o sumar apoyo.
Las cifras de adopción respaldan esto. La investigación State of Service de Salesforce (sexta edición) encontró que:
La diferencia práctica: en lugar de un panel de KPI que solo confirma lo que ya salió mal la semana pasada, un responsable ve alertas basadas en probabilidad directamente junto a sus tickets activos, con suficiente contexto para actuar de inmediato en lugar de después de una revisión retrospectiva.
Los problemas de servicio rara vez se quedan dentro de un solo departamento:
Cuando estos equipos trabajan desde el mismo sistema de recepción y priorización en lugar de herramientas separadas, los silos que normalmente ocultan estas dependencias en gran medida desaparecen: todos ven el mismo ticket y el mismo estado de SLA en lugar de reconstruirlo de segunda mano.
Los paneles compartidos en tiempo real hacen que esta visibilidad sea realmente utilizable a nivel gerencial: distribución de carga de trabajo, estado del SLA y riesgos marcados por la IA, todo en un solo lugar. Nuestro artículo sobre Por qué los líderes son siempre los últimos en saber cuando un proyecto tiene problemas profundiza en cómo construir paneles que conviertan esta visibilidad entre equipos en algo realmente accionable.
Abrir tanta visibilidad entre departamentos genera naturalmente una pregunta válida: ¿quién debería poder ver realmente un ticket de RR. HH. frente a uno de TI o una queja de un cliente? Esa es una pregunta de permisos, no de IA, y vale la pena resolverla de forma deliberada, definiendo desde el inicio del despliegue qué roles ven qué tableros, en lugar de abrir todo por comodidad y ajustarlo después de un incidente.
Darle a la IA mayor visibilidad sobre el contenido de los tickets genera una pregunta válida desde el inicio: ¿dónde vive esa información y quién puede verla realmente? Los programas de servicio con IA que funcionan bien suelen apoyarse en los mismos fundamentos:
Las organizaciones que manejan datos de clientes bajo marcos como ISO 27001, SOC 2, GDPR o HIPAA deberían confirmar cómo procesa la IA de una plataforma de servicio el contenido de los tickets dentro de esos requisitos antes de implementarla a gran escala, una conversación que conviene tener explícitamente durante la planificación, no una nota al pie para después.
Los datos globales de adopción muestran una brecha clara:
Leído de una manera, ese número parece una región rezagada. Leído de otra, parece un terreno prácticamente abierto: muy pocos equipos de servicio en la región ya dieron el salto hacia una gestión de tickets nativa en IA, lo que significa que los que lo hacen pueden diferenciarse por la disciplina en sus tiempos de respuesta mientras la mayoría de sus competidores todavía comparan paneles después de los hechos.
Esa brecha importa de forma concreta para las empresas que atienden clientes de nearshoring en Estados Unidos y Canadá, donde la confiabilidad del SLA, y no solo el costo, se volvió un factor competitivo. También importa para los equipos bilingües que manejan flujos de tickets en varios idiomas, donde la detección de sentimiento reduce el esfuerzo de detectar a tiempo un mensaje urgente antes de que quede horas sin atender.
Es especialmente relevante para el sector de BPO y soporte tercerizado, que emplea a una parte importante de la fuerza laboral de servicio en la región. Un SLA incumplido ahí no afecta solo a un cliente final; afecta el contrato con la empresa cuyos clientes se están atendiendo, una consecuencia financiera mucho mayor por cada incumplimiento.
Algunos puntos de control prácticos antes de implementar esto en toda la empresa:
Acuerda un pequeño conjunto de métricas antes de la implementación, no después:
monday service suele ser una opción más sólida para organizaciones que ya usan, o están dispuestas a adoptar, un solo Work OS entre departamentos, y que quieren que la gestión de servicio conviva con proyectos, ventas y operaciones en lugar de quedar aislada en una herramienta separada.
Las organizaciones con procesos ITIL sumamente maduros y personalizados — con años de gestión de cambios, bases de datos de configuración y flujos formales de gestión de problemas ya construidos — pueden seguir estando mejor servidas por una suite ITSM especializada. En ese escenario, lo más sensato es una comparación directa de lo que realmente soporta cada plataforma hoy, no una elección por defecto.
La gestión de SLA deja de ser algo sobre lo que un equipo reporta después de los hechos y pasa a ser algo que la IA protege activamente en tiempo real, desde el momento en que llega un ticket hasta el momento en que se resuelve. Ninguno de los tres agentes descritos aquí requiere un equipo de ciencia de datos para configurarse ni una implementación de seis meses para mostrar valor; funcionan sobre datos que un equipo de servicio ya genera todos los días.
Que este cambio tenga sentido para un equipo específico sigue dependiendo del volumen actual de tickets, la estructura por departamentos y qué tan limpios están ya los datos, exactamente el tipo de evaluación que conviene hacer junto a un socio que implementa esto a diario y no adivinando desde una página de funciones.
GB Advisors trabaja con equipos de servicio de monday.com en América Latina, el Caribe y Estados Unidos exactamente en este tipo de implementaciones. Si quieres una lectura clara de cómo aplicarían las capacidades de IA de monday service al volumen y la estructura real de tu equipo, contacta a nuestro equipo.