Gestión de Incidentes en ServiceNow: Visibilidad Total de TI
September 30, 2026
La falta de visibilidad sobre los incidentes es uno de los principales desafíos que enfrentan hoy las empresas de América Latina, según el ESET Security Report Latinoamérica 2026. No es un problema exclusivo de seguridad: aparece todos los días en la mesa de servicio, cuando una misma falla llega por correo, por chat y por pasillo, y nadie puede decir con certeza cuántos incidentes siguen abiertos en ese momento.
Imagina esta escena: a las 9:40 de la mañana, un servicio de aprobación de pagos empieza a fallar. A las 9:52, un gerente de tienda envía un correo a soporte. A las 9:58, un líder regional de TI recibe un WhatsApp que dice "el sistema está lento otra vez". A las 10:05, alguien se acerca al escritorio de soporte en el tercer piso a reportar lo mismo, con otras palabras. Cuatro señales distintas, un solo incidente real, y ningún lugar donde alguien pueda ver las cuatro al mismo tiempo.
Esto no habla de un equipo lento. Habla de lo que ocurre cuando las solicitudes de TI llegan por correo, chat y conversaciones de pasillo sin un sistema de registro compartido detrás. El incidente termina reportado, casi siempre más de una vez, casi siempre por más de una persona, y casi nunca con la información que un técnico realmente necesita: qué servicio está afectado, qué otros sistemas dependen de él y cuánto tiempo lleva corriendo ya el reloj del SLA.
En este artículo revisamos por qué se forma esa brecha de visibilidad incluso en equipos de TI capaces y bien intencionados, qué le cuesta a la empresa cuando nadie nota un SLA vencido hasta que ya es tarde, y cómo una plataforma de gestión de servicios conectada, con un portal único, un espacio de trabajo unificado para el agente y una CMDB confiable, cierra esa brecha de principio a fin.
La falta de visibilidad casi nunca se presenta como un costo. Se disfraza de frases como "estamos un poco más lentos de lo normal" o "los tickets tardan más de lo que deberían", lo suficientemente vagas como para que nadie les ponga un número encima. Cuando las organizaciones sí se detienen a medirlo, el número es difícil de ignorar:
La mayoría de las brechas de visibilidad en incidentes tienen la misma raíz: el sistema que debería decirle a un técnico qué está conectado con qué está incompleto o desactualizado. Estudios del sector ubican la precisión promedio de una CMDB alrededor del 60%, lo que significa que los técnicos trabajan con un mapa del entorno que está equivocado cuatro de cada diez veces. Otro análisis independiente encontró que solo una de cada cuatro organizaciones obtiene un valor operativo real de su inversión en CMDB, a pesar de haberla hecho.
Esa brecha importa porque la respuesta a un incidente depende de saber qué está afectado. Un técnico que no puede ver que el "servicio de aprobación de pagos" y la "API de caja de tienda" comparten el mismo servidor de aplicaciones tratará dos tickets como dos problemas distintos en lugar de uno solo. La cola de tickets crece, el diagnóstico tarda más, y quienes reportan la falla siguen llamando porque nada cambia a simple vista.
Cuando un incidente se convierte en una caída de servicio, cada minuto cuesta dinero. El estudio de costo de tiempo de inactividad de ITIC encontró que el costo por hora de una caída supera los 300,000 dólares para nueve de cada diez empresas medianas y grandes, y para cuatro de cada diez de esas organizaciones supera el millón de dólares por hora. Cada minuto adicional que se gasta averiguando por qué canal llegó el primer reporte, o qué sistema falló realmente, se suma directamente a esa factura.
Las mesas de servicio de mejor desempeño siguen de cerca la tasa de incumplimiento de SLA, el tiempo promedio de atención y la resolución en el primer contacto como indicadores reales de salud del servicio, no solo el volumen de tickets. El problema es que un reloj de SLA sigue corriendo esté alguien mirándolo o no. Una solicitud registrada por correo a las 9:52 y la "misma" solicitud registrada por chat a las 9:58 pueden terminar como dos relojes de SLA distintos, ambos corriendo, sin ninguna conexión entre sí, y ambos eventualmente vencidos porque nadie los unió a tiempo. En el reporte mensual de SLA, eso aparece como dos incumplimientos en lugar de un solo incidente, inflando silenciosamente cada métrica de cumplimiento con la que se mide al equipo de TI.
La falta de visibilidad no solo retrasa el incidente que todos pueden ver, también multiplica el trabajo detrás de él en silencio. Cuando cuatro canales generan cuatro reportes distintos de la misma caída, un equipo puede terminar abriendo, clasificando y eventualmente fusionando o cerrando cuatro tickets en lugar de uno. Cada uno de esos tickets adicionales sigue consumiendo la atención de un técnico el tiempo suficiente para leerlo, clasificarlo y darse cuenta de que duplica algo que ya estaba en proceso. Multiplicado a lo largo de una mesa de servicio que atiende cientos de tickets por semana, ese impuesto de duplicación puede absorber una parte importante de la capacidad total del equipo, una capacidad que nunca aparece como "desperdiciada" en ningún reporte porque cada minuto se gastó en un ticket que, a simple vista, parecía legítimo.
La brecha de visibilidad casi nunca es una sola falla. Son tres fallas más pequeñas apiladas una sobre otra, y cada una esconde a la siguiente:
Correo, chat, un mostrador de soporte, una llamada telefónica: cada canal parece razonable por sí solo. El correo deja rastro. El chat es rápido. Una conversación de pasillo resuelve el problema de una persona en ese momento. La falla es de arquitectura, no de comportamiento: sin un sistema de registro compartido detrás de cada canal, cada uno crea su propia vista parcial de lo que está pasando. La dirección de TI termina haciendo una pregunta que debería tener respuesta inmediata, como cuántos incidentes siguen abiertos en este momento, y recibe tres números distintos según quién responda.
Esto se vuelve especialmente visible durante una caída real. En los primeros quince minutos, las personas mejor posicionadas para coordinar una respuesta suelen ser las últimas en enterarse de que el incidente ya se está reportando por otras tres puertas.
Incluso cuando una solicitud sí llega a una cola central, con frecuencia llega sin la información que permitiría actuar sobre ella rápido. Un ticket que dice "el sistema está lento" no le dice a un técnico qué servicio, qué entorno ni qué sistemas dependientes podrían también estar afectados. La categorización y la prioridad que dependen de que una persona llene correctamente un menú desplegable, bajo presión de tiempo, producen datos inconsistentes que luego hacen casi imposible reportar tendencias reales de incidentes.
El costo posterior es sutil pero real: un reporte trimestral construido sobre categorías inconsistentes no puede decirle a la dirección con confianza si los problemas de red, los errores de aplicación o las solicitudes de acceso son el verdadero motor del volumen de tickets, porque los datos de base nunca fueron lo bastante consistentes como para sostener esa conclusión.
Los técnicos suelen trabajar entre varias pantallas desconectadas: el sistema de tickets, una herramienta de monitoreo aparte, una base de conocimiento en una wiki, una ventana de chat para quien reportó el problema. Cada cambio de pantalla es un pequeño costo sobre el tiempo de resolución, y a lo largo de cientos de tickets al mes ese costo se convierte en una pérdida de capacidad medible. Es una brecha estructural, no de capacitación, por eso rara vez mejora sola, sin importar la experiencia del técnico.
Cerrar la brecha de visibilidad tiene menos que ver con sumar una herramienta nueva y más con eliminar las costuras entre las herramientas y canales que ya existen. En una implementación moderna de ServiceNow, esa conexión pasa por siete capacidades que trabajan sobre los mismos datos:
Un portal de autoservicio con catálogo de servicios, página de estado de los sistemas y artículos de conocimiento le da a cada empleado un solo lugar para reportar un problema o solicitar algo, en lugar de recurrir al correo o al chat. Al ver un catálogo con lo que puede solicitar y cuánto tiempo debería tomar, el empleado reduce la cantidad de mensajes de "solo quería saber cómo va mi solicitud" que terminan saturando los mismos canales.
Esto hace más que reducir la dispersión de canales: es el mismo cambio estructural detrás de la adopción en ServiceNow Employee Center, donde unificar cada tipo de solicitud en un solo portal, y no el diseño visual del portal, es lo que realmente mueve las cifras de adopción.
Cuando una solicitud se registra a través de un elemento estructurado del catálogo, en lugar de un correo de texto libre, la categoría y la prioridad pueden asignarse automáticamente según lo que la persona seleccionó, no según la interpretación de quien recibe el ticket. Ese solo cambio elimina una de las fuentes más comunes de datos inconsistentes y hace que el reporte de tendencias, a través de meses y no solo de tickets individuales, sea realmente confiable.
También cambia la velocidad con la que un ticket llega a la cola correcta. Un incidente de un sistema de pagos categorizado correctamente desde el momento en que se reporta salta por completo el paso manual de triage, y llega directo a un especialista en lugar de a un generalista que después tiene que reasignarlo.
El Service Operations Workspace le da al agente un resumen del caso, incidentes relacionados y artículos de conocimiento sugeridos por IA en una sola pantalla, en lugar de cuatro. El efecto práctico es menos cambios de pantalla por ticket y una primera acción correcta más rápida. También le da al técnico un lugar natural para escalar a un experto de guardia cuando un caso requiere conocimiento especializado, sin salir del espacio de trabajo para averiguar quién es esa persona o por dónde contactarla.
Para organizaciones que operan una mesa de servicio administrada sobre varios clientes o unidades de negocio, este mismo espacio de trabajo se convierte en el lugar donde empiezan a verse patrones entre tickets, no solo casos aislados: tres tickets que a simple vista no tienen relación, pero que en realidad comparten la misma dependencia de fondo, son mucho más fáciles de detectar cuando un agente puede ver los incidentes relacionados sin cambiar de pantalla.
Los tableros en tiempo real sobre incidentes abiertos, estado del SLA y tiempo promedio de resolución le permiten a un equipo ver el riesgo acumulándose antes de que se convierta en un incumplimiento, en lugar de reconstruir después lo que pasó. Esto es lo opuesto al problema de fatiga de alertas que erosiona la confianza en los sistemas de monitoreo cuando cada señal parece igual de urgente; un tablero construido alrededor del riesgo de SLA destaca los pocos casos que realmente necesitan atención ahora mismo, en lugar de una pared de notificaciones que termina enseñando al equipo a ignorarlas todas.
Un gerente que revisa ese tablero a las 9:50 de la mañana ve el incidente del sistema de pagos marcado como en riesgo de incumplir su SLA antes de que el cuarto canal siquiera lo reporte, y esa es la diferencia entre una escalación proactiva y una disculpa reactiva.
Cuando un chat en vivo con un usuario final puede convertirse directamente en un incidente registrado, la conversación misma pasa a formar parte del historial en lugar de desaparecer cuando se cierra la ventana. El usuario gana continuidad: no tiene que repetirle el problema a una segunda persona por correo. El técnico hereda el contexto en lugar de partir de un ticket en blanco, incluyendo los pasos de diagnóstico que el chat ya descartó.
Nada de lo anterior funciona bien sin una CMDB que refleje la realidad. El descubrimiento automático, un mapa de relaciones entre elementos de configuración y una medida visible de la salud de los datos convierten la CMDB de un ejercicio de cumplimiento en una herramienta operativa que los técnicos consultan de verdad durante un incidente. Cuando un servidor se cae, un técnico que trabaja sobre una CMDB actualizada puede ver de inmediato cada aplicación, servicio y dependencia que corre sobre ese servidor, en lugar de descubrir el alcance completo del impacto ticket por ticket, a lo largo de la siguiente hora.
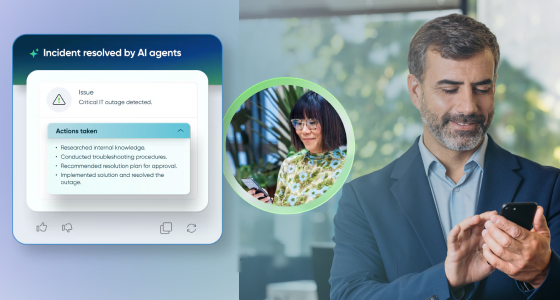
Esta es la misma base de datos que determina hasta dónde puede llegar realmente la orquestación de agentes de IA dentro de la plataforma: un agente de IA que recomienda una solución, o un resumen de incidente generado por IA, es tan confiable como los datos de configuración sobre los que razona. Los equipos que invierten primero en la salud de la CMDB antes de ampliar sus casos de uso de IA suelen obtener resultados más confiables de esos mismos casos de uso después, por la misma razón que un pronóstico es tan bueno como los datos detrás de él.
Workflow Studio permite construir reglas de automatización para las partes repetitivas de la gestión de incidentes, enrutamiento, notificación y escalación, sin escribir código a la medida para cada escenario. Una regla que notifica automáticamente a un equipo específico cuando se etiqueta un incidente P1 contra un servicio de negocio determinado elimina un paso manual que de otro modo depende de que alguien recuerde hacer una llamada. La meta es reservar el criterio humano para los casos que de verdad lo necesitan, en lugar de gastarlo en decisiones que siempre siguen la misma regla.
Vale la pena decirlo sin rodeos, aunque muchas comparaciones de ITSM lo pasan por alto: estas capacidades valen tanto como la plataforma que las sostiene. Un conjunto de herramientas separadas, ensambladas para simular un espacio de trabajo unificado, se comporta distinto bajo carga que una plataforma diseñada desde el inicio sobre un solo modelo de datos, que es justo la diferencia arquitectónica que separa a las plataformas modernas de las herramientas de ITSM heredadas. En el papel, dos listas de funciones pueden verse idénticas, mientras la experiencia real, sobre todo cuando sube el volumen de incidentes, se separa de forma marcada.
La forma de la brecha de visibilidad cambia según la industria, aunque la causa de fondo es la misma:
En todos los casos, la solución tiene la misma estructura: darle a cada canal un camino hacia un solo sistema de registro, y darle a ese sistema suficiente información de configuración para entender qué afecta realmente cada ticket.
Los canales de solicitud fragmentados no son exclusivos de ninguna región, pero el patrón aparece con particular intensidad en las empresas de América Latina y el Caribe:
La propia investigación regional sobre seguridad y operaciones lo confirma de forma directa. El ESET Security Report Latinoamérica 2026 identificó la falta de visibilidad sobre los incidentes como uno de los principales desafíos de las organizaciones de la región, junto al phishing y las debilidades en la protección de identidad, una señal de que el problema de visibilidad va más allá de cualquier industria o tamaño de empresa en particular, y está entre los primeros temas que los propios líderes de TI de la región señalan como pendientes.
Para empresas de banca, seguros, manufactura, telecomunicaciones y sector público que operan en varios países de la región, la visibilidad de incidentes también es una pregunta de cumplimiento y auditoría. Una CMDB con vacíos es una CMDB que no puede sostener de forma confiable un proceso de gestión de cambios, algo que los auditores cada vez exigen más documentar con evidencia de qué cambió, cuándo y a qué afectó. Varios reguladores de la región están exigiendo con más rigor los reportes de resiliencia operativa, y un registro de incidentes fragmentado hace ese reporte más lento y más difícil de sustentar de lo necesario.
El idioma y la cobertura por turnos añaden una capa que la mayoría de las guías globales de ITSM no contemplan. Una multinacional que opera en varios países de LatAm puede tener mesas de servicio en distintos idiomas y husos horarios, lo que hace que un sistema de registro compartido sea aún más valioso: es el único lugar donde un traspaso entre turnos o países no depende de que alguien traduzca un hilo de WhatsApp para el siguiente equipo.
Cerrar una brecha de visibilidad tan estructural no ocurre en una sola fase de proyecto, pero el orden importa más de lo que la mayoría espera.
Ninguno de estos pasos exige reemplazar de inmediato todas las herramientas que un equipo ya usa. Lo que exigen es una plataforma capaz de convertirse en el sistema de registro compartido al que finalmente reporta cada canal, cada ticket y cada elemento de configuración.
Si tu equipo de TI puede responder en segundos cuántos incidentes siguen abiertos, quién los atiende y qué está afectado, sin revisar tres herramientas distintas, ya tienes la visibilidad que describe este artículo. Si esa pregunta necesita una reunión para responderse, la brecha es estructural, y cerrarla empieza por mapear dónde se originan realmente tus incidentes hoy.
En GB Advisors trabajamos con equipos de TI empresariales en toda América Latina y el Caribe para diseñar e implementar soluciones de ServiceNow que cierran exactamente este tipo de brecha de visibilidad, desde el portal de autoservicio hasta una CMDB en la que los técnicos puedan confiar durante un incidente activo. Conversa con nuestro equipo sobre cómo se vería cerrar esta brecha en tu organización de TI.